TOON: Benarkah Format Baru Ini Bisa Menggantikan JSON dan Menghemat Biaya AI?
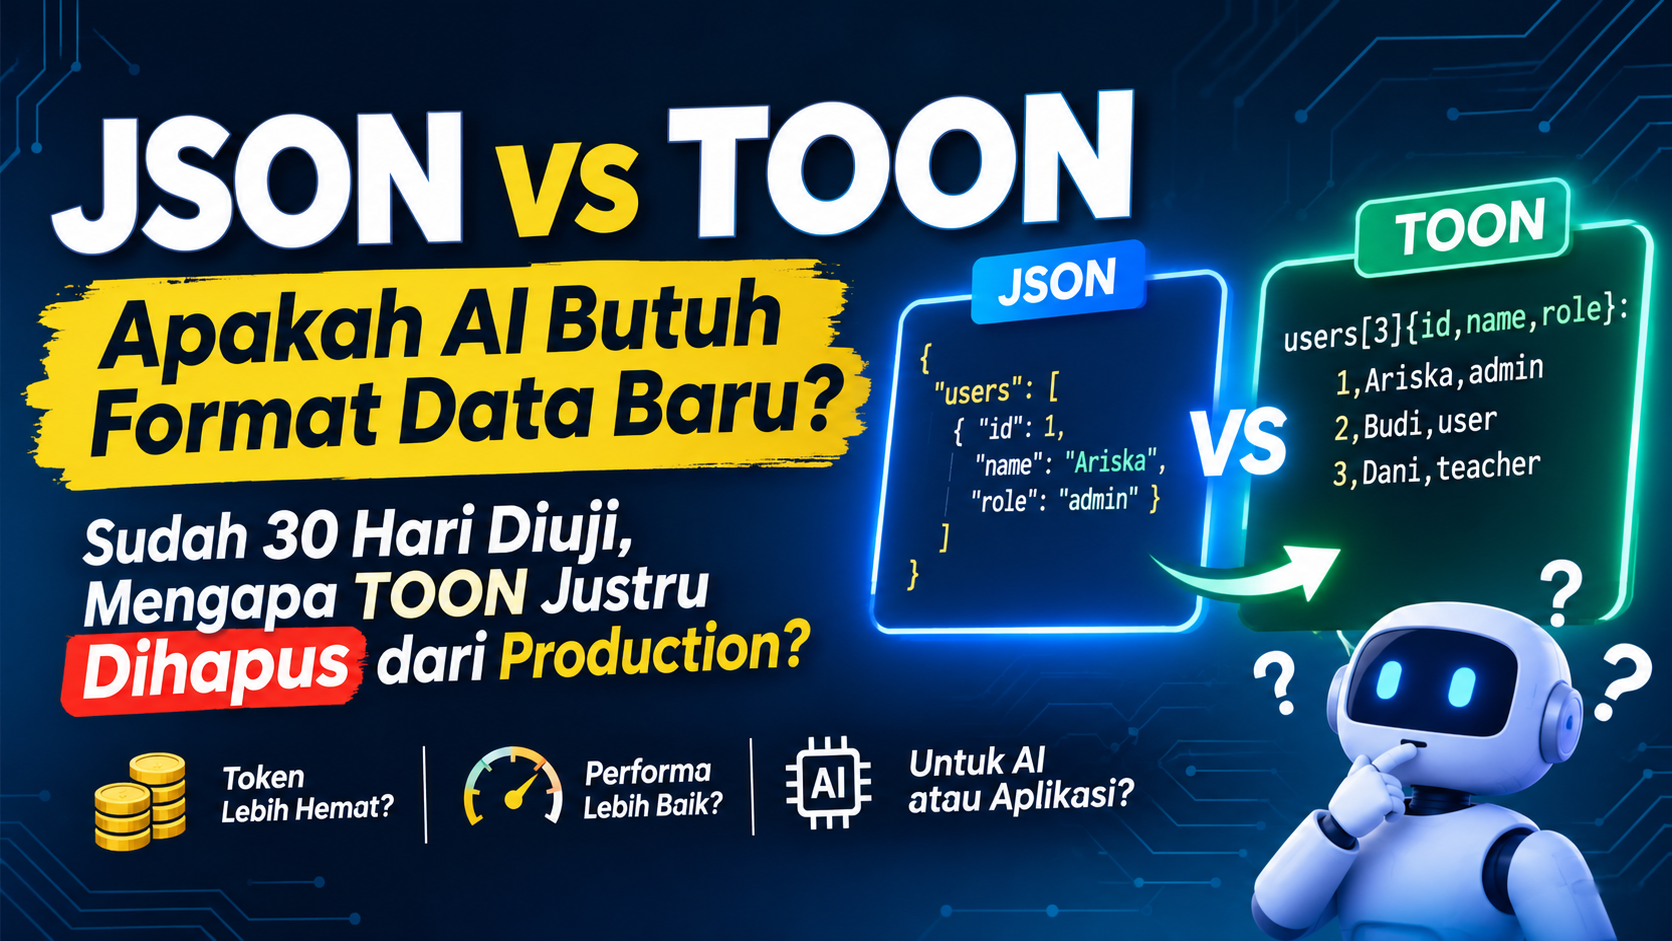
Selama bertahun-tahun JSON menjadi standar pertukaran data antar aplikasi. Namun, ketika data yang sama harus dibaca oleh AI, apakah JSON masih menjadi format paling efisien?
Kita terbiasa menggunakan JSON hampir di setiap bagian pengembangan aplikasi.
Mulai dari REST API, komunikasi frontend dan backend, konfigurasi aplikasi, database, hingga integrasi layanan pihak ketiga. JSON sudah menjadi bagian yang sulit dipisahkan dari dunia software development.
Namun, perkembangan Large Language Model (LLM) membawa persoalan baru.
Ketika aplikasi mulai terintegrasi dengan AI, data tidak hanya dikirim untuk diproses oleh program, tetapi juga dimasukkan ke dalam konteks model bahasa.
Di sinilah muncul persoalan yang mungkin belum terlalu diperhatikan oleh banyak developer: apakah format data yang nyaman untuk aplikasi juga merupakan format paling efisien untuk AI?
Salah satu format yang mencoba menjawab persoalan tersebut adalah TOON (Token-Oriented Object Notation).
TOON menawarkan representasi data yang lebih ringkas, terutama untuk kumpulan objek dengan struktur seragam. Tujuannya adalah mengurangi pengulangan informasi ketika data diberikan kepada LLM.
Tetapi, apakah TOON benar-benar bisa menggantikan JSON?
Mari kita lihat dari sisi teknis, efisiensi token, dan pengalaman penerapannya.
1. Masalah yang Tidak Terlihat: AI Tidak Selalu Membutuhkan JSON yang Berulang
Bayangkan sebuah aplikasi memiliki 1.000 data pengguna.
Setiap pengguna memiliki informasi ID, nama, dan role.
Dalam JSON, bentuk datanya seperti ini:
{
  "users": [
    {
      "id": 1,
      "name": "Ariska",
      "role": "admin"
    },
    {
      "id": 2,
      "name": "Budi",
      "role": "user"
    },
    {
      "id": 3,
      "name": "Dani",
      "role": "teacher"
    }
  ]
}
Perhatikan bahwa setiap objek mengulang nama properti yang sama:
- id
- name
- role
Pengulangan ini memang tidak menjadi masalah besar bagi aplikasi biasa. JSON mudah dibaca, diproses, dan memiliki dukungan luas.
Namun, ketika ribuan objek dimasukkan ke dalam prompt AI, pengulangan tersebut ikut berkontribusi terhadap jumlah token.
Dalam sistem yang memproses banyak data, token menjadi salah satu komponen biaya operasional.
Inilah masalah yang ingin dioptimalkan oleh TOON.
2. Mengenal TOON: Data yang Ditulis Lebih Ringkas
TOON merupakan singkatan dari Token-Oriented Object Notation.
Format ini menggunakan struktur berbasis indentasi dan representasi tabular untuk data yang memiliki bentuk seragam.
Data sebelumnya dapat ditulis seperti ini:
users[3]{id,name,role}:
  1,Ariska,admin
  2,Budi,user
  3,Dani,teacher
Apa yang berubah?
TOON mendeklarasikan nama properti satu kali pada bagian header:
users[3]{id,name,role}
Kemudian setiap baris berisi nilai sesuai urutan kolom.
Dengan demikian, nama properti tidak perlu diulang pada setiap objek.
Secara sederhana, perbedaannya:
- JSON merepresentasikan setiap objek dengan struktur key-value.
- TOON dapat merepresentasikan kumpulan objek seragam sebagai tabel.
- TOON tetap mempertahankan struktur data JSON, bukan menghilangkan makna datanya.
TOON memiliki beberapa bentuk representasi, termasuk inline, list, tabular, dan keyed tabular. Jadi, format ini tidak hanya berlaku untuk data berbentuk tabel.
Spesifikasinya saat ini berada pada versi 4.4, berstatus Working Draft, sehingga masih dapat mengalami perubahan.
Dokumentasi: https://github.com/toon-format/spec
3. Mengapa Token Menjadi Penting dalam Pengembangan AI?
Untuk memahami alasan TOON muncul, kita perlu memahami cara LLM memproses informasi.
LLM bekerja menggunakan token, bukan menghitung karakter atau jumlah baris seperti manusia.
Token merupakan unit teks yang digunakan model dalam proses pemrosesan bahasa.
Ketika kita mengirimkan data kepada AI, data tersebut ikut menggunakan token dalam context window.
Misalnya, sebuah AI Agent harus membaca:
- 500 data produk.
- 1.000 riwayat transaksi.
- 200 data pelanggan.
- Ribuan catatan aktivitas pengguna.
Jika setiap objek memiliki properti yang sama, pengulangan nama properti dapat menambah jumlah token yang dikirim.
Dampaknya bisa meliputi:
- Meningkatnya penggunaan token input.
- Bertambahnya biaya API pada layanan yang mengenakan biaya berdasarkan token.
- Berkurangnya ruang context window yang tersedia untuk informasi lain.
- Potensi peningkatan latensi akibat pemrosesan konteks yang lebih besar.
Namun, perlu diingat bahwa token tidak selalu berbanding lurus dengan jumlah karakter atau ukuran file.
Karena itu, format yang terlihat lebih pendek belum tentu menggunakan token lebih sedikit.
4. Apakah TOON Benar-Benar Lebih Hemat daripada JSON?
Ini bagian yang menarik.
Benchmark resmi TOON menguji efisiensi token sekaligus kemampuan model mengambil informasi dari data.
Dalam benchmark yang dipublikasikan pada dokumentasi TOON, pengujian dilakukan menggunakan 244 pertanyaan retrieval pada empat model.
Hasil agregat yang dilaporkan:
| Format | Token | Akurasi |
|---|---|---|
| TOON | 2.474 | 72,2% |
| JSON compact | 2.892 | 69,0% |
| YAML | 3.487 | 70,1% |
| JSON | 4.308 | 71,4% |
| XML | 4.909 | 70,7% |
Pada benchmark tersebut, TOON menggunakan 42,6% lebih sedikit token dibanding JSON yang diformat dengan indentasi.
Tetapi ada catatan penting.
Angka tersebut bukan berarti TOON selalu menghemat 42,6% dibanding semua implementasi JSON.
Jika dibandingkan dengan JSON compact atau JSON yang sudah diminimalkan, hasilnya bisa berbeda.
Bahkan pada beberapa jenis data, TOON justru menggunakan lebih banyak token.
Sumber benchmark: https://toonformat.dev/guide/benchmarks
5. Eksperimen Apify: Ketika TOON Justru Dihapus dari Production
Ada satu eksperimen menarik yang layak diperhatikan developer.
Pada 30 Oktober 2026, tim Apify mempublikasikan pengalaman mereka menggunakan TOON pada MCP Server selama 30 hari.
Mereka mencoba mengoptimalkan representasi data yang dikirim kepada AI Agent.
Awalnya, TOON terlihat menjanjikan.
Pada contoh tiga data Actor Run, hasil pengukuran mereka menunjukkan:
| Format | Jumlah token |
|---|---|
| JSON dengan indentasi | 191 |
| JSON compact | 143 |
| TOON | 123 |
TOON terlihat lebih hemat dibanding JSON compact pada contoh tersebut.
Namun, ketika diuji menggunakan data produksi yang lebih beragam, hasilnya tidak selalu sama.
Dalam pengujian terhadap 100 data Google Maps Places, TOON menggunakan sekitar 11,7% lebih banyak token dibanding JSON.
Pada pengujian lain, data berupa halaman web juga tidak menunjukkan penghematan yang berarti.
Apify menjalankan dua putaran A/B testing.
Hasilnya tidak menunjukkan keuntungan yang konsisten. Pada putaran pertama, TOON menggunakan 0,7% lebih banyak token agent. Pada putaran kedua, TOON menggunakan 1,7% lebih sedikit.
Perbedaan hasil ini membuat mereka memutuskan menghapus TOON dari implementasi production.
Namun, eksperimen tersebut bukan bukti bahwa TOON tidak berguna.
Justru ada pelajaran yang lebih penting:
Optimasi yang berhasil pada benchmark belum tentu memberikan manfaat yang sama pada beban kerja produksi.
TOON unggul ketika data memiliki struktur seragam. Sebaliknya, data hasil scraping, objek bersarang, dan properti opsional dapat mengurangi keunggulannya.
Apify juga menemukan bahwa pemilihan field yang benar-benar dibutuhkan AI dapat memberikan pengurangan ukuran data yang jauh lebih besar daripada sekadar mengganti format serialisasi.
Sumber: https://aaif.io/blog/we-added-toon-to-our-mcp-server-then-removed-it
6. Kapan TOON Lebih Cocok Digunakan?
Tidak semua data cocok menggunakan TOON.
Format ini paling menarik ketika kita memiliki kumpulan objek dengan struktur seragam.
Contohnya:
Cocok untuk diuji:
- Daftar produk dengan properti yang sama.
- Data transaksi dengan struktur konsisten.
- Daftar pengguna.
- Data statistik dan time series.
- Hasil query database berbentuk tabel.
- Metadata yang diberikan kepada AI Agent.
Perlu diuji lebih hati-hati:
- Data hasil web scraping.
- JSON dengan banyak nested object.
- Data dengan banyak field opsional.
- Struktur yang sangat tidak konsisten.
- Data yang mengandung array bersarang.
Untuk beberapa kasus, JSON compact masih bisa lebih efisien.
Jadi, keputusan penggunaan format sebaiknya berdasarkan struktur data dan hasil pengukuran token, bukan tren teknologi.
7. Cara Mencoba TOON di JavaScript dan TypeScript
Bagi developer JavaScript atau TypeScript, TOON sudah memiliki implementasi yang dapat dicoba.
Instalasi:
npm install @toon-format/toon
Contoh penggunaan:
import { encode, decode } from "@toon-format/toon";

const data = {
  users: [
    { id: 1, name: "Ariska", role: "admin" },
    { id: 2, name: "Budi", role: "user" },
    { id: 3, name: "Dani", role: "teacher" }
  ]
};

// Mengubah JSON-compatible object menjadi TOON
const toon = encode(data);

console.log(toon);

// Mengembalikan TOON menjadi object
const restored = decode(toon);

console.log(restored);
Keuntungan pendekatan ini adalah kita tidak perlu mengubah keseluruhan struktur aplikasi.
Data tetap dapat disimpan sebagai object JavaScript biasa.
TOON hanya digunakan ketika kita membutuhkan representasi alternatif untuk dikirimkan kepada LLM.
Dokumentasi dan implementasi: https://github.com/toon-format/toon
8. Apakah Developer Harus Beralih dari JSON ke TOON?
Menurut saya, belum.
JSON sudah memiliki ekosistem yang sangat matang.
Hampir semua bahasa pemrograman modern mendukung JSON. REST API, database, frontend, backend, message broker, dan layanan pihak ketiga juga sudah banyak menggunakannya.
Mengganti JSON secara menyeluruh hanya karena muncul format yang lebih ringkas bukan keputusan arsitektur yang bijak.
Lebih masuk akal menggunakan pendekatan hybrid.
Misalnya:
Database
Tetap menyimpan data dalam struktur database yang sesuai, seperti tabel relasional PostgreSQL atau JSONB ketika memang diperlukan.
Backend dan API
Tetap menggunakan JSON untuk komunikasi antarsistem.
AI Gateway
Melakukan transformasi data menjadi TOON ketika hasil benchmark menunjukkan penghematan token.
AI Agent / LLM
Menerima representasi data yang sudah dioptimalkan sesuai kebutuhan model.
Dengan pendekatan ini, kita tidak perlu mengorbankan interoperabilitas aplikasi hanya demi optimasi AI.
9. Ada Optimasi yang Sering Terlupakan: Jangan Kirim Data yang Tidak Dibutuhkan
Dari eksperimen Apify, ada satu pelajaran yang menurut saya lebih penting daripada sekadar memilih TOON atau JSON.
Mengurangi data yang tidak dibutuhkan sering kali jauh lebih efektif daripada mengganti format serialisasi.
Bayangkan AI hanya diminta mencari nama dan harga produk.
Namun, backend mengirimkan seluruh informasi berikut:
- ID internal.
- Nama produk.
- Deskripsi panjang.
- Kategori.
- Harga.
- Stok.
- Riwayat perubahan.
- Informasi pemasok.
- Metadata internal.
- Timestamp.
Padahal AI hanya membutuhkan dua field.
Mengapa harus mengirim semuanya?
Kita bisa melakukan field projection:
const productsForAI = products.map(product => ({
  name: product.name,
  price: product.price
}));
Kemudian hasilnya dapat diubah ke TOON jika memang lebih efisien.
Pendekatan ini memberikan dua lapisan optimasi:
- Mengurangi jumlah informasi yang tidak relevan.
- Mengoptimalkan representasi informasi yang memang dibutuhkan.
Dalam pengembangan AI Agent, keduanya perlu diperhatikan.
Kesimpulan: Masa Depan Bukan Tentang Mengganti JSON, tetapi Mengirim Data dengan Lebih Cerdas
TOON merupakan perkembangan menarik dalam dunia AI engineering.
Format ini menunjukkan bahwa cara kita merepresentasikan data dapat memengaruhi efisiensi penggunaan LLM.
Namun, TOON belum menjadi pengganti universal JSON.
Keduanya memiliki tujuan penggunaan yang berbeda.
JSON tetap menjadi pilihan yang sangat kuat untuk interoperabilitas aplikasi, sedangkan TOON menawarkan alternatif representasi data yang menarik untuk komunikasi dengan LLM, khususnya pada kumpulan objek seragam.
Bagi developer, pelajaran terbesarnya bukan sekadar mempelajari format baru.
Melainkan mulai berpikir lebih kritis tentang bagaimana data dikirimkan kepada AI.
Apakah semua field benar-benar diperlukan?
Apakah struktur data bisa dibuat lebih sederhana?
Apakah format yang digunakan benar-benar mengurangi token?
Dan yang paling penting, apakah optimasi tersebut terbukti memberikan manfaat dalam kondisi produksi?
Karena dalam pengembangan AI, efisiensi bukan hanya tentang menggunakan model yang lebih murah. Terkadang, kita justru perlu memperbaiki cara kita memberikan informasi kepada model tersebut.
About the author
I am an enthusiastic researcher and developer with a passion for using technology to innovate in business and education.
Comments
Join the discussionNo comments yet. Be the first to comment.